Выгрузка в хранилища данных
Выгрузка регулярно копирует данные проекта в ваше хранилище: профили, события, а по выбору — сообщения, сегменты, согласия и товары. Аналитики работают с ними в своих инструментах: строят отчёты в BI, соединяют с данными учётной системы, обучают модели.
Обратное направление — чтение изменённых строк из вашего хранилища в профили и события — делает источник данных.
Раздел — Данные → Хранилища данных. Выгрузка в хранилища доступна на тарифе «Корпоративный», см. Тарифы.
Куда можно выгружать
| Хранилище | Как данные попадают туда |
|---|---|
| S3 (AWS, Yandex Object Storage, MinIO) | файлы NDJSON.gz в ваш бакет |
| Google Cloud Storage | файлы NDJSON.gz в ваш бакет |
| BigQuery | таблицы в датасете проекта Google Cloud |
| Snowflake | таблицы в схеме; данные идут через ваш бакет AWS S3 |
| ClickHouse | таблицы в базе на вашем сервере |
| PostgreSQL | таблицы в схеме на вашем сервере |
Сначала хранилище подключают на странице Интеграции в группе Хранилища данных: доступы, затем Проверить.
- S3 — бакет, ключи доступа, для Yandex Object Storage и MinIO — адрес API.
- Google Cloud Storage и BigQuery — ключ сервисного аккаунта (JSON). Для Cloud Storage аккаунту нужна роль Storage Object User на бакет, для BigQuery — роли BigQuery Data Editor и BigQuery Job User. У BigQuery ещё указывается расположение данных:
EU,USили регион. - Snowflake — аккаунт, пользователь и его закрытый ключ RSA без пароля, роль, warehouse для вычислений и бакет AWS S3 с ключами. Открытый ключ задайте пользователю командой
ALTER USER … SET RSA_PUBLIC_KEY. - ClickHouse — адрес HTTP-интерфейса, например
https://ch.example.com:8443, пользователь и пароль. - PostgreSQL — хост, порт, база, пользователь, пароль и шифрование соединения.
Сервер ClickHouse или PostgreSQL должен быть доступен из интернета: адреса внутренних сетей не принимаются.
Как создать выгрузку
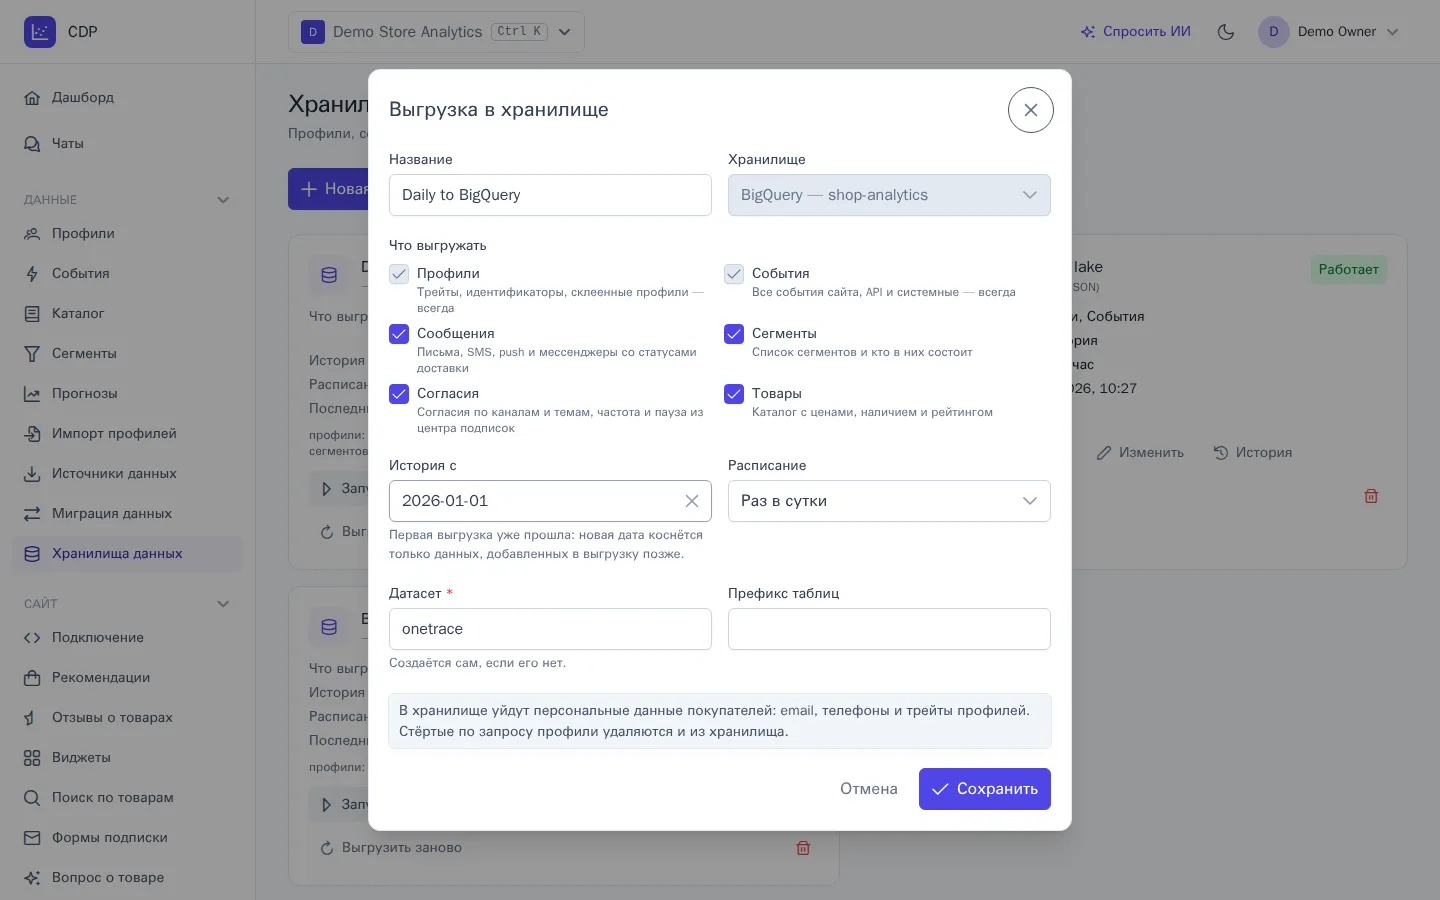
- Нажмите Новая выгрузка.
- Укажите название и выберите Хранилище — его нельзя сменить после создания.
- Отметьте, что выгружать. Профили и события выгружаются всегда.
- В поле История с выберите дату, с которой выгрузить события и сообщения в первый раз, или оставьте поле пустым — тогда выгрузится вся история. Профили, сегменты, согласия и товары выгружаются целиком.
- Выберите Расписание: каждый час, раз в 3, 6, 12 часов или раз в сутки.
- Заполните настройки хранилища: папку в бакете, датасет BigQuery, базу и схему Snowflake, базу ClickHouse или схему PostgreSQL. Датасет, база и схема создаются сами, если их нет. Префикс таблиц нужен, если в одну базу пишут несколько выгрузок.
- Нажмите Сохранить. Первая выгрузка начнётся в течение минуты.
Первая выгрузка большой истории идёт частями и может занять несколько часов — пока она не закончится, на карточке видна метка Первая выгрузка. Следующие запуски передают только то, что изменилось с прошлого раза.
Что выгружается
| Данные | Таблицы | Что в них |
|---|---|---|
| Профили | profiles |
трейты, идентификаторы (email, телефон, user_id …), первое и последнее посещение, склейка (merged_into_id) и удаление |
| События | events |
все события сайта, API и системные ($message_*, $segment_* и другие), свойства и контекст |
| Сообщения | messages |
канал, тема, шаблон, рассылка и вариант, цепочка, статус и время каждого статуса, получатель |
| Сегменты | segments, segment_members |
список сегментов; кто в сегменте сейчас, когда вошёл и вышел |
| Согласия | consents, preferences |
согласия по каналам и темам; частота и пауза из центра подписок |
| Товары | products |
каталог с ценами, наличием, категориями, характеристиками и рейтингом |
Таблица событий только дописывается. Остальные таблицы обновляются по ключу: изменённый профиль, сообщение или товар заменяет прежнюю строку. Трейты, свойства и контекст событий — JSON. Время — в UTC.
Таблицы создаются сами; если в новой версии OneTrace.pro у таблицы появится колонка, она будет добавлена.
Особенности хранилищ:
- S3 и Google Cloud Storage — файлы лежат в папках по таблицам и датам выгрузки, например
events/dt=2026-10-29/. В обновляемых таблицах текущая строка ключа — последняя поupdated_at. Схемы таблиц — в папке_schema. - BigQuery — события разбиты по дням события и сгруппированы по имени события и профилю, поэтому запросы за период читают меньше данных.
- ClickHouse — обновляемые таблицы читайте с
FINAL, JSON хранится строкой: значения доставайте функциямиJSONExtract….
Стёртые профили
Когда профиль стирают по запросу покупателя (см. Профили), следующий запуск выгрузки удаляет его строки и из хранилища: из профилей, событий, сообщений, членства в сегментах и согласий. В S3 и Google Cloud Storage уже записанные файлы не меняются: список стёртых профилей кладётся в папку _erasures, и удалить их строки у себя нужно вам.
Запуски и ошибки
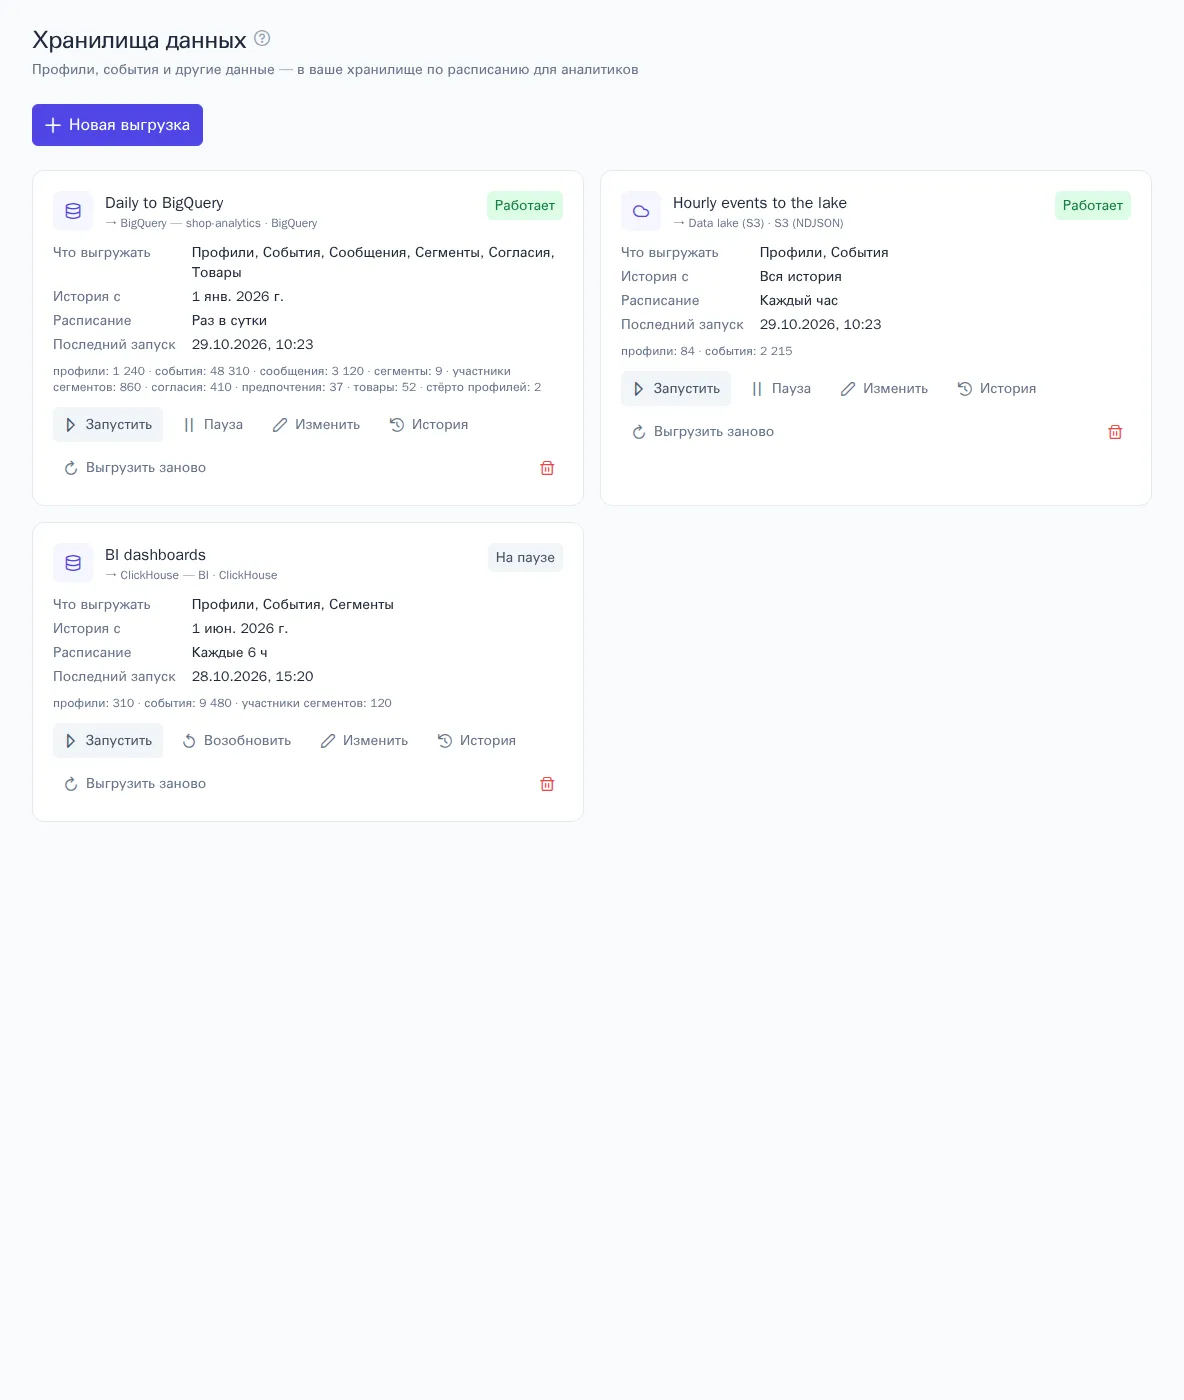
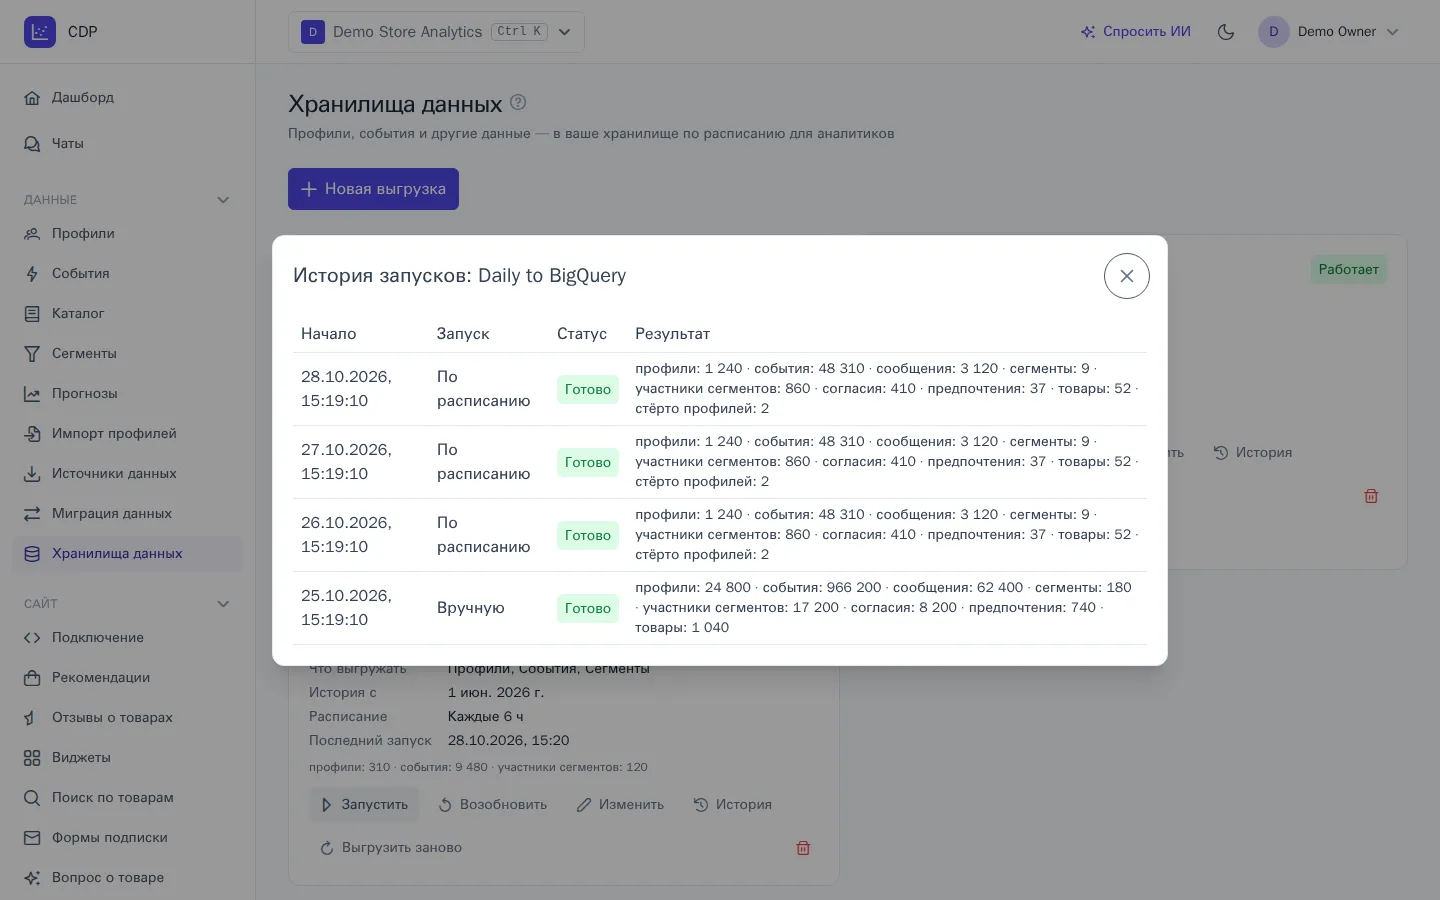
На карточке выгрузки видны расписание, последний запуск и сколько строк ушло в каждую таблицу. История показывает последние запуски.
- Запустить — выгрузить изменения сейчас, не дожидаясь расписания.
- Пауза — остановить выгрузку; изменения копятся и уйдут после Возобновить.
- Выгрузить заново — следующий запуск отправит все данные, как в первый раз. Если таблицы в хранилище не очищены, события в них задвоятся.
Если хранилище временно недоступно, выгрузка повторит запуск через 1, 5, 15, 30 и 60 минут и продолжит с того места, где остановилась: уже принятые части не отправляются дважды. Если доступ отозван или база не найдена, на карточке появится ошибка — исправьте подключение на странице Интеграции, и следующий запуск продолжит выгрузку.
Кто может настраивать выгрузки
В хранилище уходят персональные данные покупателей. Поэтому раздел видят роли с правом выгрузки профилей, а создавать, менять и запускать выгрузки могут те, у кого ещё есть права на управление интеграциями и на персональные данные без маскирования. Из системных ролей это «Владелец» и «Администратор». Подробнее — в статье Участники и роли.